Over het platform
Over Praxikon
Praxikon is een gratis platform dat de EU AI Act omzet in wat u moet doen en moet kunnen aantonen. Het bepaalt per AI-systeem welke verplichtingen gelden, welke acties daaruit volgen, welk bewijs daarbij hoort en wat een wijziging in de regelgeving daaraan verandert. Elk antwoord is herleidbaar tot de officiële EU-bron, met versie en datum. De gegevens zijn ook beschikbaar via een publieke API voor software en AI-agents.
Deze definitie staat woordelijk gelijk op de homepage, in de metadata, in de gestructureerde data en in de bestanden voor AI-crawlers. Eén formulering op alle oppervlakken, zodat er iets te citeren valt in plaats van vier bijna-versies.
Alle kennis hier is vrij toegankelijk, zonder account, voor juristen en compliance-teams net zo goed als voor de AI-modellen die eruit citeren.
Waarom Praxikon bestaat
Aan meningen over de AI Act is geen gebrek. Er verschijnt elke week een samenvatting, een stappenplan of een waarschuwing, en die stukken spreken elkaar op de randen tegen. Waar het aan ontbreekt is bewijs: welke regel geldt, waar dat precies staat, welke uitgave van die bron is gelezen, op welke datum, en hoe u over een jaar laat zien dat u het toen zo wist.
Een organisatie die haar AI-gebruik moet verantwoorden heeft weinig aan een tekst die klopt op het moment van lezen en daarna stil verandert. Zij heeft een uitspraak nodig die zij kan citeren: met een identifier die niet hernoemd wordt, een versie die vastligt, en een spoor terug naar de officiële tekst.
Praxikon is voor dat tweede gebouwd. Niet nog een uitleg van de verordening, maar de laag eronder: de objecten waarop een uitleg kan rusten, in een vorm die een mens leest en een machine ophaalt.
Missie en visie
De missie
De regelgeving herleidbaar en reproduceerbaar maken, voor mensen, software en AI-agents in dezelfde beweging. Herleidbaar betekent dat elke gepubliceerde uitspraak de officiële bron draagt waarop zij steunt, tot op het artikellid, met uitgaveversie en controledatum. Reproduceerbaar betekent dat dezelfde vraag tegen dezelfde uitgave van de dataset hetzelfde antwoord geeft, ook nadat de regelgeving verder is geschoven.
De visie
De referentielaag worden waar anderen naar verwijzen, in plaats van dat iedere adviseur, ieder hulpmiddel en ieder taalmodel de verordening opnieuw modelleert en daarbij zijn eigen sleutels verzint. Dat vraagt precies wat een referentie tot referentie maakt: identifiers die nooit worden hernoemd of hergebruikt, versies die vastliggen, correcties die zichtbaar zijn in plaats van stil overschreven, en een publieke interface waarover software dezelfde objecten leest als de pagina die u nu voor u heeft.
Wat dat niet is
Een richting, geen toezegging. Er staat vandaag geen serviceniveau op de publieke interface, er wordt niets bezorgd, en het platform velt geen oordeel over een systeem dat bij u draait. Wie een melding wil, haalt hem zelf op. Dat staat er liever meteen bij dan dat u het gaandeweg ontdekt.
Regelgeving als infrastructuur
Achter elk antwoord ligt een kennisgraph in plaats van een tekstpagina. Elk object draagt een stabiele identifier, een versie en een hash, en verwijst naar de officiële EU-bron waar het vandaan komt.
Een correctie overschrijft niets: zij is een nieuwe versie met een latere datum. Daardoor blijft een citaat van vorige maand controleerbaar, ook nadat de regelgeving is opgeschoven.
Software en AI-agents lezen precies dezelfde objecten via de publieke API als de pagina die u nu leest. Eén dataset, twee lezers, geen tweede waarheid.
De lagen, van bron naar antwoord
Hieronder staat in leesvorm wat de doorloop aan een echte casus laat zien. Wie liever kijkt dan leest, neemt die pagina: daar gaat een werkgever die sollicitanten laat rangschikken door alle lagen heen, en staat onder elke stap afgedrukt wat de draaiende motor teruggaf.
De bronlaag
Officiële teksten en documenten worden geregistreerd als eigen object: welke uitgave, welke vindplaats, en wanneer wij ernaar keken. Die registratie krijgt een vingerafdruk. Zij is geen archiefkopie van het document zelf, en de officiële bron gaat altijd boven onze samenvatting ervan.
De kennisgraph
Daarboven staan de objecten: verplichtingen, acties, bewijsstukken, definities en wijzigingen. Elk object draagt een stabiele identifier, een versie, een hash over zijn inhoud en de citaties naar de bronlaag. De inhoud is tweetalig voordat er iets wordt getoond, dus de taal is presentatie en geen tweede inhoud.
De beslislaag
Een vaste set gecodeerde antwoorden gaat de beoordeling in, en er komt een classificatie uit met het redeneerspoor eronder: welke regel is voldaan, welke niet, en waarom. Er zit geen taalmodel tussen. Wat buiten de beoordeelde set viel staat erbij, want niet beoordeeld is iets anders dan niet van toepassing.
Het manifest
Dezelfde beoordeling past in een document dat u kunt archiveren of meesturen, met de datasetversie, de gebruikte bronvingerafdrukken, de beoordeelde verplichtingen en een hash over het geheel. Dezelfde invoer tegen dezelfde uitgave levert dat document opnieuw op, tot op de byte.
De impactlaag
Wijzigingen in de regelgeving zijn zelf objecten, met twee datums: wanneer het recht bewoog en wanneer wij dat wisten. Een bestaand manifest kan tegen een venster tussen twee uitgaven worden gelegd. De uitkomst is een status met een vervolgstap, geen score en geen percentage.
De uitgangen
Bovenop die lagen liggen twee uitgangen: de pagina die u leest, en de publieke interface waarover software en AI-agents dezelfde objecten ophalen. Beide projecteren uit dezelfde graph, dus ze kunnen niet uit elkaar lopen zonder dat de dataset zelf verandert.
Het bewijs achter deze belofte
Alles hierboven is een claim tot u hem kunt nalopen. Dit is waar dat kan.
De methodologie
Hoe een uitspraak in de graph terechtkomt, hoe duiding gescheiden blijft van wettekst, welke reviewstatus wat betekent, en wanneer iets opnieuw wordt beoordeeld.
Lees de methodologieHet correctieregister
Een inhoudelijke fout wordt niet stil overschreven. Elke materiële correctie staat met datum en toelichting in het openbare register, naast de uitgave waarin zij landde.
Bekijk de correctiesDe ontologie en het stabiliteitscontract
De vorm van elk objecttype, het identifierbeleid, de twee tijdassen en het citatieformaat liggen vast in de documenten ONTOLOGY.md, VERSIONING.md en LEGAL-MODEL.md. De gepubliceerde projectie daarvan is de JSON-LD-context, en die kunt u nu openen.
Open de JSON-LD-contextDe publieke interface
Per verplichting de citaties met vindplaats, bron-URL en de Europese ELI-identifier, plus de datasetversie waartegen u leest. Het contract staat in het OpenAPI-document.
Bekijk het OpenAPI-documentWaar Praxikon voor staat
Het platform verkoopt zelf geen advies, geen implementatie en geen training. Die scheiding is bewust: een bron die ook de opdracht wil binnenhalen, leest anders dan een bron die dat niet hoeft.
Bronherleidbaar of het staat er niet
Elke verplichting draagt de vindplaats waarop zij steunt, tot op het artikellid. Bij de duiding staat erbij dat het duiding is, gescheiden van de wettekst zelf.
Kennis open, ook voor machines
Pagina's, de implementatiekaart, de antwoorden en de publieke API zijn vrij toegankelijk en citeerbaar. Alleen downloadbare bestanden vragen eenmalig een zakelijk e-mailadres.
Deterministisch, geen taalmodel
Antwoorden worden samengesteld uit versieerde objecten in de kennisgraaf. Er zit geen generatief model tussen dat een plausibel klinkende zin kan verzinnen.
Datum en release erbij
Elk antwoord toont wanneer het is gecontroleerd en uit welke uitgave van de dataset het komt. Zonder die stempel is een citaat niet te reproduceren.
Hoe u dit kunt controleren
Betrouwbaarheid die u op ons woord moet geloven is geen betrouwbaarheid. Dit is wat u zelf kunt nalopen:
- De publieke API geeft per verplichting de citaties terug, met de exacte vindplaats, de bron-URL en de Europese ELI-identifier.
- Het bronregister bij elk antwoord noemt uitgever, uitgaveversie en controledatum, zodat u weet welke uitgave is gebruikt.
- De methodologie beschrijft hoe een uitspraak in de graaf komt en wanneer die opnieuw wordt beoordeeld.
- De vingerafdruk bij een bron zegt er zelf bij waarover hij gaat: onze registratie van de bron, geen archiefkopie van het externe document.
Wat er in het platform zit
Stand van de kennisgraaf op dit moment. Deze 14 bronrecords zijn de uitgaven waarnaar de uitgewerkte verplichtingen citeren. Het bronnenoverzicht bij de richtsnoeren telt 59 afzonderlijke officiële documenten: die bredere naslag bevat ook uitleg die nog aan geen enkele verplichting is gekoppeld. Bekijk het bronnenoverzicht
Implementatiekaart
Bepaal per AI-systeem of GPAI-model welke routes gelden, met timing, acties, bewijs en open vragen. Zonder account, het dossier blijft lokaal.
Directe antwoorden
Stel een vraag in gewone taal en krijg de conclusie, de eerste acties en de officiële bron. Samengesteld uit de graaf, niet gegenereerd.
Monitor en wijzigingen
Wat er materieel verandert in de regels, met de status en de bron erbij, zodat u ziet wat om herbeoordeling vraagt.
Handhaving per lidstaat
Aangewezen toezichthouders, uitvoeringswetgeving en gedateerde handhavingsgebeurtenissen voor alle 27 lidstaten.
Bewijs en templates
Registers, checklists en documenten per verplichting, bewerkbaar en direct bruikbaar.
Publieke API en llms.txt
Dezelfde kennis machine-leesbaar, met stabiele object-ID's, versies en citaties, zodat een AI-agent er correct naar kan verwijzen.
Praxikon, Embed AI en LearnWize
Praxikon is de neutrale kennis- en beslislaag. Het verkoopt zelf geen advies, geen implementatie en geen training, en het beveelt binnen een antwoord geen leverancier aan. Dat is geen bescheidenheid maar een voorwaarde: een laag waarop een derde partij durft te bouwen, kan niet tegelijk meedingen naar de opdracht die uit haar eigen antwoord volgt.
De uitvoering ligt bij twee merken van dezelfde maker, en die scheiding staat hier expliciet zodat u weet wat u leest. Embed AI voert uit, LearnWize traint. Beide lezen dezelfde publieke objecten als u: er is geen tweede kennisgraph achter een deur, en geen plek in een antwoord die te koop is.
Embed AI
Voor compliance, legal, risk en IT
Governance, AI-register, classificatie, FRIA en het bewijsdossier, begeleid in een vaste aanpak.
Bekijk de aanpak van Embed AILearnWize
Voor HR, L&D, opleiders en programmamanagers
Rolgerichte leerpaden en toetsing onder artikel 4, met certificaten en een audit-klaar dossier per medewerker.
Bekijk LearnWizeWie dit schrijft
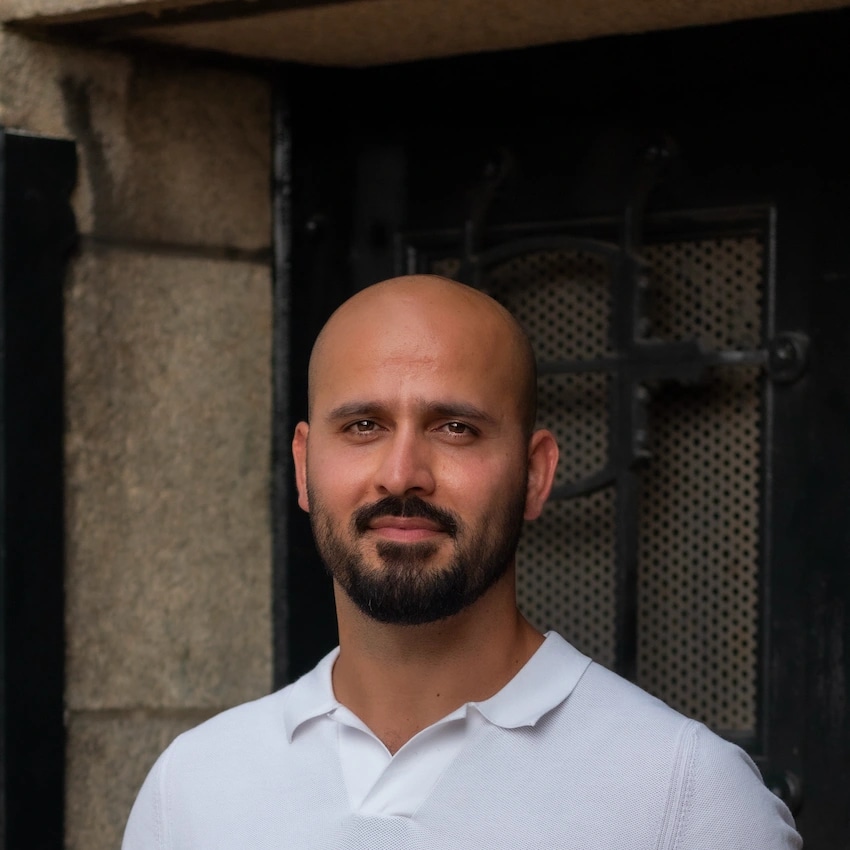
Zahed Ashkara
Oprichter, Praxikon
Jurist en AI governance specialist · Certified AI Compliance Officer (CAICO) · Lid NEN-normcommissie AI & Big Data
Zahed helpt organisaties om AI verantwoord in te zetten: van risicoclassificatie en governance tot AI-geletterdheid op de werkvloer. Hij werkt met organisaties in onder meer HR, onderwijs, zorg, finance en overheid, en vertaalt de AI Act daar naar concrete stappen en bewijs dat standhoudt bij interne review, toezichthouders en bestuur.
Naast dit platform is Zahed oprichter van LearnWize, waarmee organisaties verantwoord AI-gebruik trainen, toetsen en per rol aantoonbaar maken, en van adviespraktijk Embed AI, een door de NOvA erkende opleidingsinstelling. Als lid van de NEN-normcommissie Artificial Intelligence & Big Data werkt hij bovendien mee aan de normen waarop AI Act-audits straks worden gebaseerd.
Bekijk het expertprofiel van ZahedWaar Zahed dagelijks aan werkt
Spreker en trainer
Zahed geeft regelmatig presentaties en trainingen over AI governance, de EU AI Act en verantwoord AI-gebruik. Elk publiek is anders: gemeenteambtenaren hebben andere vragen dan juristen of IT-security teams.
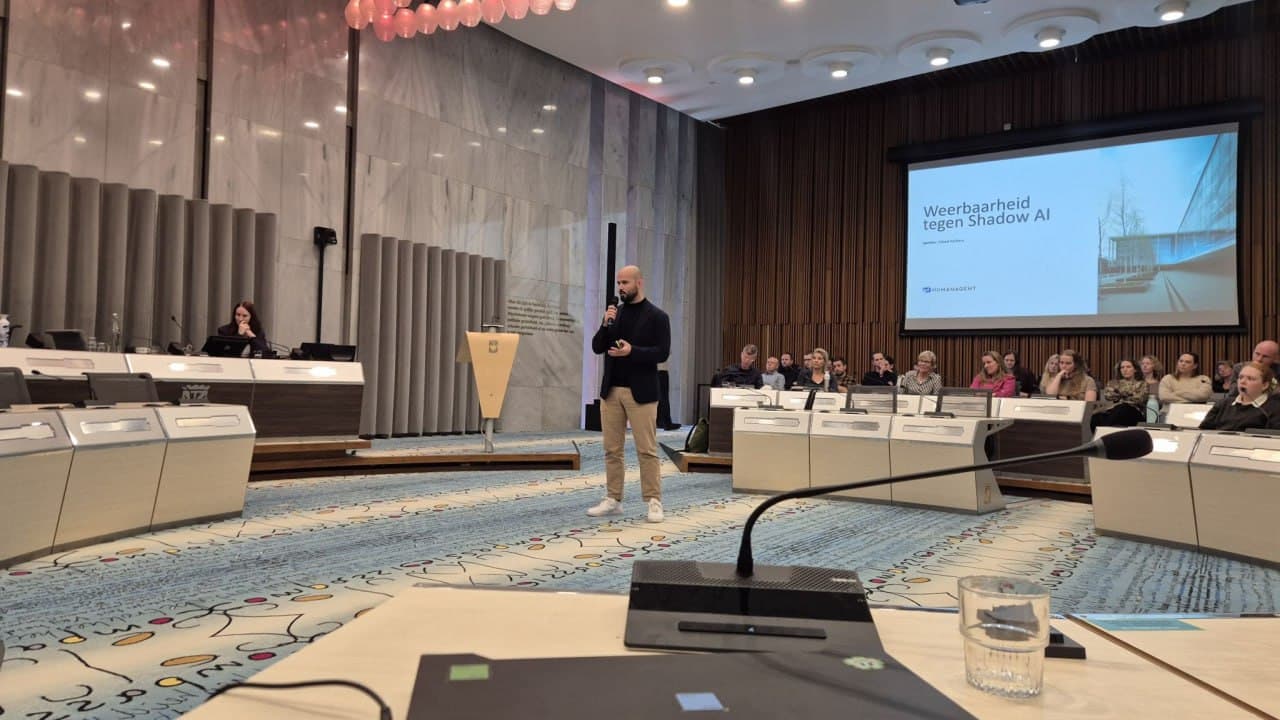
Gelderse AI-dag, Stadhuis Arnhem
Sessie over digitale weerbaarheid en Shadow AI voor gemeenteambtenaren tijdens de Gelderse AI-dag
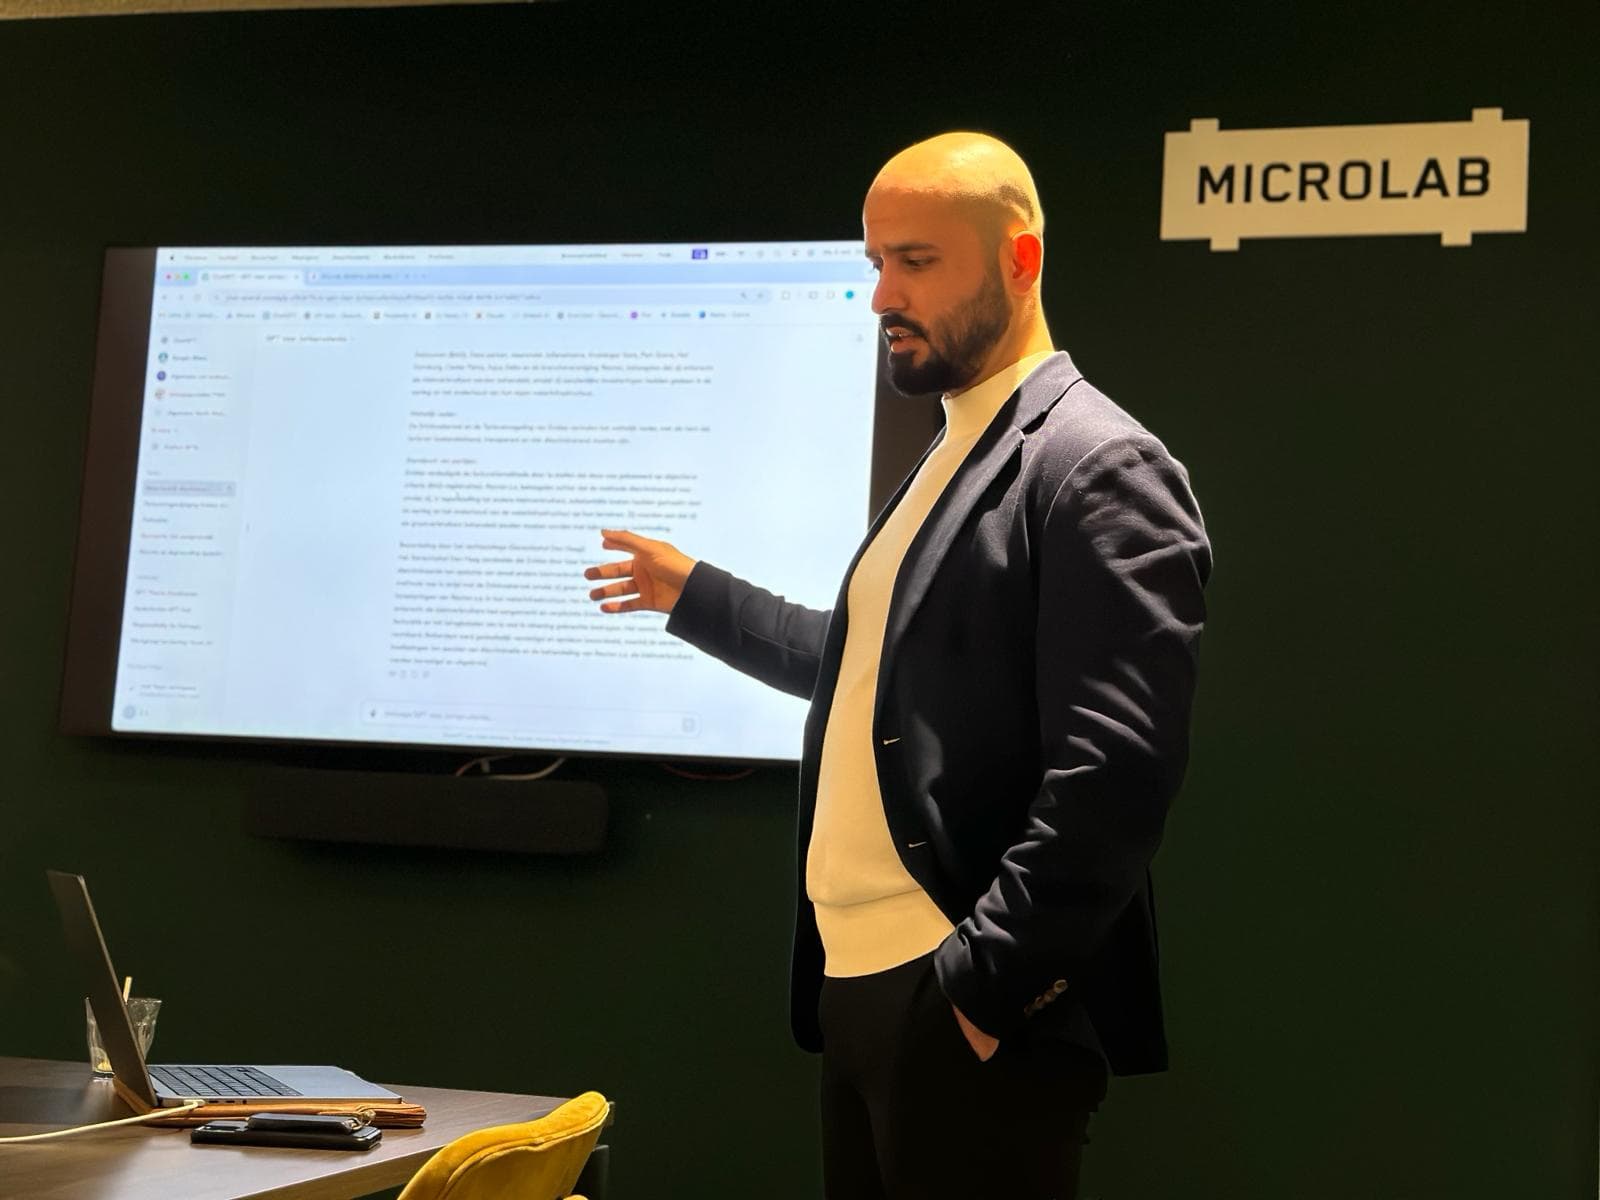
Microlab Den Haag, GPT voor jurisprudentie
Demonstratie van custom GPT voor jurisprudentie-analyse, voor juristen en advocaten
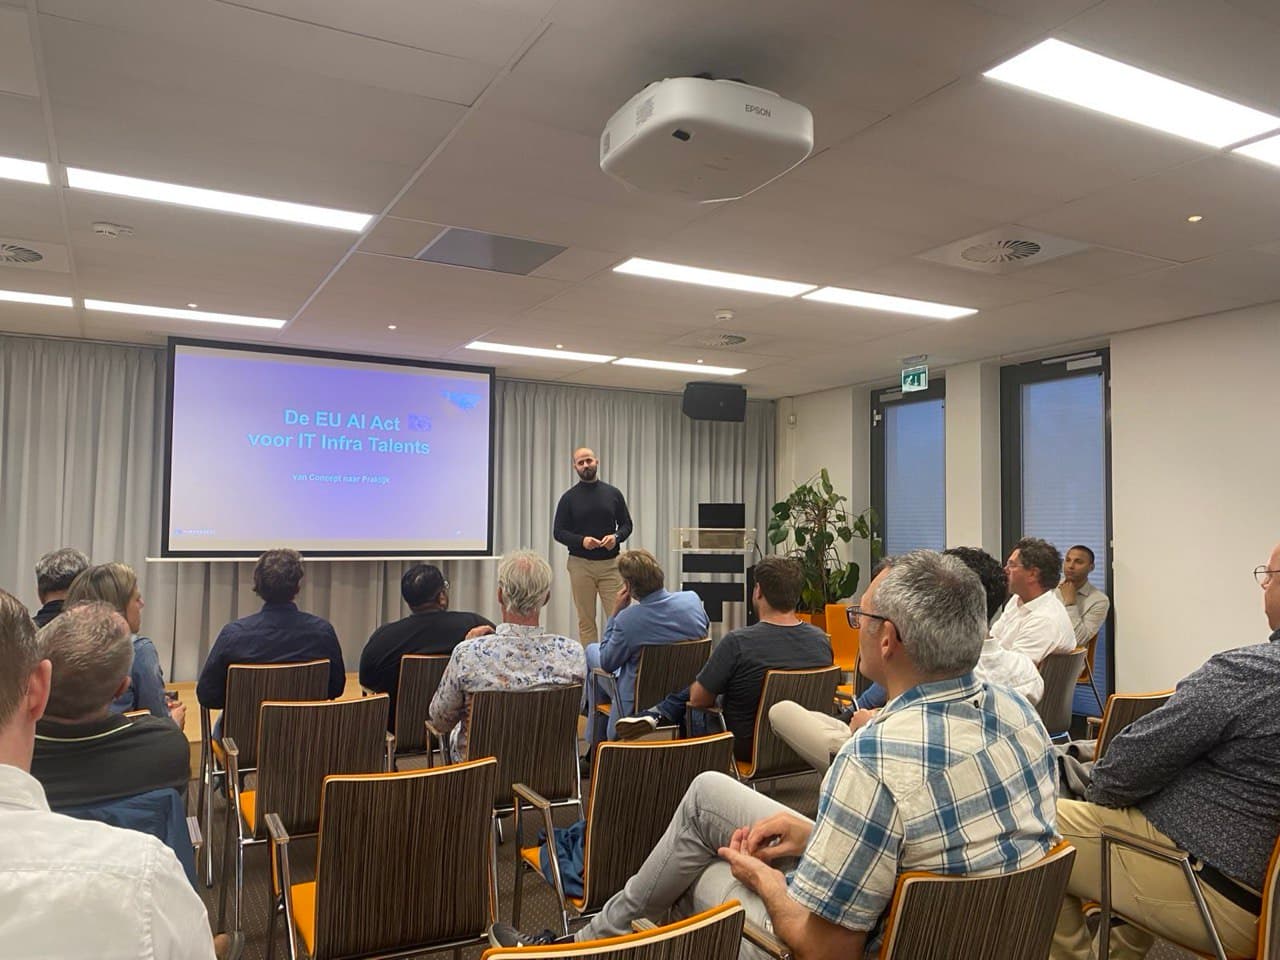
IT Infra Talents
Presentatie over de EU AI Act voor IT-infrastructuur en security professionals
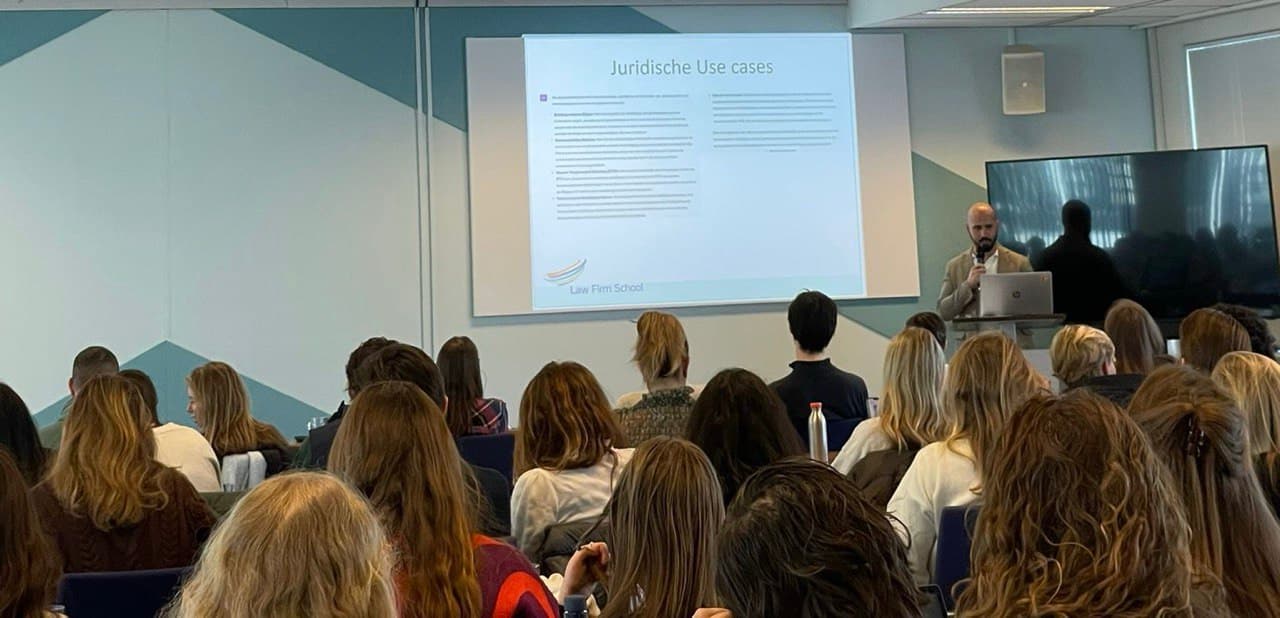
The Law Firm School
Training over juridische AI use cases en verantwoord gebruik voor advocaten en juridische professionals
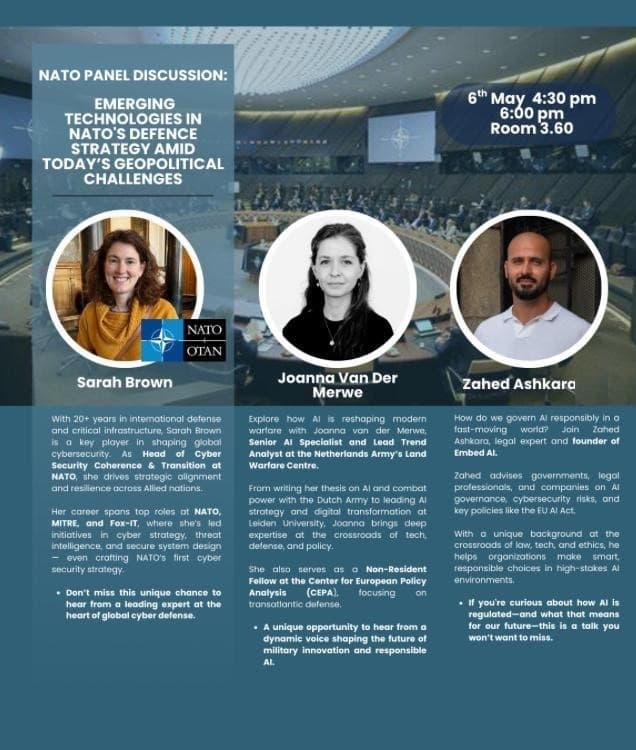
NATO panel: Emerging Technologies & Defence Strategy
Paneldiscussie over AI governance in een fast-moving world en de rol van de EU AI Act
Blijf op de hoogte van de AI Act
Ontvang onze nieuwsbrief met praktische updates over de EU AI Act, toezicht en AI-governance.
Werk- en privéadressen welkom · Geen spam · Altijd opzegbaar
Een fout gevonden of een vraag over het platform
Een onjuiste verwijzing, een gemiste bron of een verplichting die scherper kan: die meldingen zijn welkom en worden nagelopen. Voor de uitvoering van een traject verwijzen we door naar Embed AI of LearnWize.